Belajar Ragam Strategi Deep Learning dengan CIFAR10 Dataset

Semester lalu di salah satu tugas kuliah Computer Vision, kita diminta untuk membuat model CNN dengan dataset CIFAR10. Awalnya ngira ini kayak MNIST dataset yang satset train nggak sampai 10 epoch dapet akurasi >90%. Ternyata dataset ini lebih kompleks. Menariknya, dari satu tugas sederhana ini, Pak Dosen mengenalkan para mahasiswa tentang beragam strategi di deep learning.

Di tutorial ini kita akan coba membuat model machine learning untuk dataset CIFAR10. Kita akan buat modelnya dari scratch menggunakan PyTorch dan tidak menggunakan pre-trained model agar kita bisa lebih dalam memahami apa yang terjadi. Kita juga akan menarget (sebagai tantangan) untuk mendapatkan akurasi >85% dalam 40 epoch.

Source code tutorial ini tersedia dalam bentuk Google Colab di sini (akan terus dilengkapi komentar dan catatan pada notebook tersebut)

Catatan: Artikel ini tidak membahas dasar-dasar deep learning menggunakan PyTorch. Bagi yang ingin tahu dasar deep learning atau dasar PyTorch bisa mengunjungi artikel terkait di blog ini:

CIFAR10 Dataset

Dataset CIFAR10 adalah dataset citra berukuran 32×32 pixel berwarna. Sesuai namanya, CIFAR10 terdiri dari 10 kelas (kucing, burung, …, kapal). Jelas dataset ini berbeda dari MNIST yang hanya hitam putih. Selain itu jika dilihat di paper-paper, rata-rata akurasi yang diperoleh untuk CIFAR10 adalah sekitar 92% (dibanding MNIST yang bisa sampai >98%). Meskipun begitu, dataset ini masih tergolong mudah dan cocok untuk buat latihan klasifikasi citra. Dataset CIFAR10 bisa didownload langsung menggunakan perintah dari PyTorch.

Sebastian Raschka, machine learning researcher yang bukunya cukup populer, juga berpendapat CIFAR10 termasuk salah satu dataset yang cocok untuk latihan.
Continue reading

Membuat Model Tensorflow Object Detection untuk Android

Artikel ini adalah kelanjutan dari artikel setahun yang lalu sebelumnya tentang Tensorflow Object Detection. Di artikel sebelumnya kita fokus pada penyiapan data, kali ini kita akan membahas cara melatih dan membuat model deep learning Tensorflow Object Detection menggunakan Google Colab, hingga akhirnya siap digunakan di Android.

Pada tutorial ini kita menggunakan Tensorflow versi 2, yang sedikit berbeda dengan Tensorflow versi 1. Ini salah satu alasan artikel ini tertunda cukup lama, tahun lalu ketika artikel pertama ditulis, Tensorflow versi 2 masih belum cukup stabil untuk object detection maupun untuk diconvert ke TFLite.

Overview

Secara umum ada 3 tahapan untuk membuat model tensorflow untuk mendeteksi objek dan menjadikan model tersebut siap digunakan di Android:

  1. Menyiapkan dataset. Jika objek yang ingin kita bukan objek yang umum dideteksi, maka kita perlu menyiapkan dataset terlebih dahulu. Tahap ini sudah dibahas di artikel sebelumnya.
  2. Melatih pre-trained model. Kita akan menggunakan pre-trained model, karena untuk merangkai dan melatih model dari awal akan memakan waktu dan membutuhkan resource yang besar. Kita cukup melakukan fine-tuning model agar model memiliki performa yang baik, untuk dataset baru, dengan waktu pelatihan yang lebih singkat.
  3. Mengconvert model menjadi TFLite. Proses mengubah model yang sudah dilatih ke format yang dapat dipahami oleh mobile Android.

Source Code

Tutorial Tensorflow Object Detection ini tersedia di Google Colab berikut: https://colab.research.google.com/drive/1dNIIcDBMaKieGzSl1BVE5H6wu17n6cO7?usp=sharing. Untuk dataset dan script-script lain yang akan digunakan dapat diakses di repository github berikut: https://github.com/rianrajagede/object-detection.git. Tutorial ini merujuk pada link Google Colab dan repo github di atas.

1. Instalasi Tensorflow Object Detection

Ketika kita menginstall Tensorflow, kita belum menginstall Tensorflow Object Detection API. Hal ini juga berlaku di Google Colab, kita tetap perlu menginstall Tensorflow Object Detection API terlebih dahulu. Langkah instalasi resminya bisa diakses di sini. Saat artikel ini ditulis instalasi bisa dilakukan dengan:

1. Clone github Tensorflow Object Detection API di Google Colab. Penanda tanda seru (!) di awal baris menunjukkan baris tersebut sedang menjalankan perintah Command Prompt, bukan Python. Perintah ini akan membuat folder models yang berisi file-file dari repository tensorflow object detection.

!git clone https://github.com/tensorflow/models.git

2. Lalu install API menggunakan perintah di bawah. Penanda %%bash fungsinya mirip dengan tanda !, jika perintah %%bash ditulis di awal baris menunjukkan cell Google Colab tersebut sedang menjalankan perintah Command Prompt, bukan Python.

%%bash
cd models/research/
protoc object_detection/protos/*.proto --python_out=.
cp object_detection/packages/tf2/setup.py .
python -m pip install .

3. Jalankan test untuk memastikan instalasi berhasil dengan menjalankan perintah berikut. Jika semua tertulis “OK” berarti instalasi berhasil.

!python models/research/object_detection/builders/model_builder_tf2_test.py
Continue reading
batch epoch step

Batch, Epoch, Step. Istilah-istilah pada Gradient Descent

Ketiga istilah di atas sering muncul ketika kita sedang belajar atau implementasi model neural network, khususnya ketika membahas Gradient Descent. Batch, epoch, dan step, adalah sebagian istilah yang digunakan menjelaskan proses iterasi di Gradient Descent. Istilah-istilah itu tidak hanya ditemukan di buku teori, tetapi juga di dokumentasi-dokumentasi framework yang akan kita gunakan. Karenanya, sangat penting untuk bisa membedakannya dengan baik.

Gradient Descent

Gradient descent adalah algoritma optimasi yang digunakan untuk menemukan parameter yang menghasilkan nilai minimum pada suatu fungsi. Dalam kasus neural network, Gradient Descent digunakan untuk menemukan bobot model terbaik yang menghasilkan error minimum. Detail perhitungan gradient descent contohnya ada pada partikel sebelumnya, sedangkan implementasinya dapat di baca di artikel berikut ini.

Secara umum, langkah yang dilakukan untuk mencerdaskan model neural network menggunakan gradient descent adalah sebagai berikut:

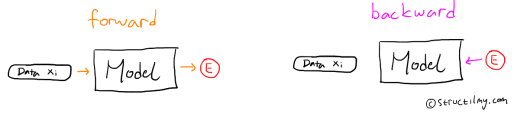
  1. Sebuah input-xi masuk ke model neural network, lalu menghasilkan output / error Ei (forward propagation)
  2. Gradient descent terhadap output / error E untuk mengupdate nilai bobot model W (backward propagation)
  3. Lakukan kedua langkah di atas terhadap semua data berkali-kali hingga diperolah model terbaik.

Untuk kemudahan penjelasan, poin no. 1 di atas akan kami sebut sebagai Langkah 1 (bold dengan warna orange) dan poin no. 2 akan kami sebut sebagai Langkah 2 (bold dengan warna ungu)

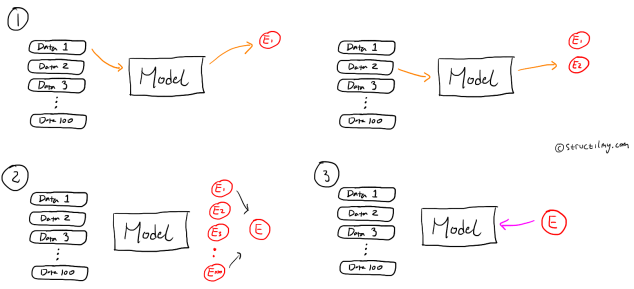
Langkah-langkah di atas masih cukup umum, Jika ada lebih dari satu data langkahnya seperti apa? Dari sinilah akan muncul istilah-istilah di awal tadi. Misalkan kita memiliki 100 data latih, maka urutan yang dilakukan pada Gradient Descent adalah:

  1. Lakukan Langkah 1 untuk setiap data (dari data latih ke 1 hingga 100), sehingga diperoleh 100 nilai eror Ei
  2. Dari 100 nilai error itu, kita hitung rata-ratanya untuk memperoleh sebuah nilai error E
  3. Lakukan Langkah 2 menggunakan E untuk mengupdate W (hanya 1x)

Langkah diatas terjadi dalam satu epoch. Untuk mendapatkan model yang baik kita perlu mengulangi langkah di atas lebih dari satu kali (beberapa epoch).

Definisi sebuah Epoch, adalah ketika kita telah menggunakan semua data latih pada proses pelatihan. Pada contoh di atas, kita sudah melalui sebuah epoch karena kita telah menggunakan 100 data latih yang kita miliki.

Pada contoh tersebut sebuah epoch terdiri dari 100 kali Langkah 1 dan 1 kali Langkah 2.

Continue reading

Deep Learning dalam 6 Baris dengan Fastai dan Pytorch

Sebelumnya maaf semisal judulnya agak “heboh” dan terkesan click-bait 😀 tapi di artikel ini beneran saya ingin menunjukkan bahwa deep learning, khususnya image classification dengan CNN sebenarnya dapat dengan mudah dilakukan hanya dengan 6 baris kode berikut menggunakan library Fastai dan Pytorch:

dibuat menggunakan https://carbon.now.sh, versi raw ada di bawah

Artikel ini berfokus pada pengenalan singkat tentang fastai dan juga penjelasan tentang kode di atas. Tutorial lebih detail dan mendalam tentang fastai insyaAllah akan kami coba buat di artikel lain.

Berawal dari Pytorch vs Tensorflow

Sebelum kita masuk lebih dalam tentang Fastai, kita akan me-refresh singkat tentang library atau framework di deep learning. Bagi yang belum tahu, ada dua library besar yang saat ini cukup sering digunakan, yakni Pytorch dan Tensorflow. Pytorch dibuat oleh Facebook sedangkan Tensorflow oleh Google. Keduanya memiliki beragam fitur yang mendukung deep learning, salah satunya Autograd yang pernah saya bahas di artikel ini. Nah, sering kali bagi yang baru belajar deep learning akan bertanya:

Pilih pakai Pytorch atau Tensorflow?

Jawaban salah

Tensorflow itu lebih mudah dipelajari dan digunakan daripada Pytorch. Itu jawaban yang sering saya dengar. Kenapa salah? karena saya yakin kebanyakan orang yang jawab itu dia bukan sedang membandingkan Tensorflow yang murni, melainkan library tambahan yang berada di atas Tensorflow, yakni Keras. Tensorflow yang murni bisa dibilang lumayan ribet juga loh untuk dipelajari dan digunakan (apalagi pas masih versi 1.x di tahun 2019)

Jadi sekilas sejarah, dulu library deep learning itu memang susah-susah pemakaiannya (low-level). Library generasi awal, Theano, bahkan ngodingnya harus “jungkir balik” alur mikirnya. Karenanya, dibutuhkan library lagi di atasnya yang high-level (mudah dipahami dan digunakan) namun tetap terintegrasi dengan library yang low-level, lahirlah salah satunya Keras. Sekarang Keras sudah sangat terintegerasi dengan Tensorflow bahkan tidak perlu di-install terpisah. Tutorial Tensorflow-Keras pernah saya tuliskan di sini.

Jawaban benar
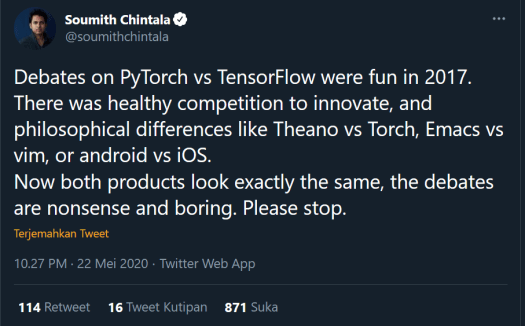
dari salah satu developer utama Pytorch

Saat ini bisa dibilang Pytorch dan Tensorflow (khususnya versi 2) sangat mirip. Keduanya sama-sama smoothly bisa digunakan untuk hampir kebanyakan kebutuhan riset dan sehari-hari. Jadi apapun librarynya silakan pilih saja, dan yang terpenting, kuasai dulu sebelum coba library lain.

Kembali ke Jawaban yang salah di atas, ketika kita membandingkan Keras dengan Pytorch maka bisa dibilang kurang apple-to-apple. Karena Keras pada dasarnya adalah high-level library sedangkan Pytorch adalah low-level library, jadi jelas Keras terlihat lebih mudah pemakaiannya. Nah, di artikel ini saya akan jelaskan salah satu high-level library paling populer untuk Pytorch, yakni Fastai.

Continue reading

Transfer Learning: Solusi Deep Learning dengan Data Sedikit

Salah satu permasalahan yang sering dialami ketika menggunakan deep learning adalah jumlah data yang sedikit. Di luar sana, sebenernya ada banyak solusi yang ditawarkan untuk mengatasi masalah ini. Nah, di sini kita akan bahas salah satunya, yakni Transfer Learning. Artikel ini akan berfokus pada teori di baliknya, sedangkan untuk implementasi akan ada di artikel selanjutnya.

Model Deep Learning

Sebelum masuk lebih dalam ke transfer learning, saya ingin mengingatkan sedikit tentang bagaimana konsep deep learning (secara umum machine learning) bekerja.

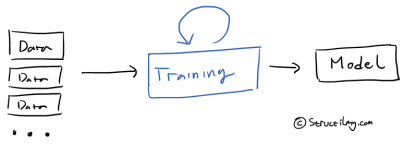
Suatu agen cerdas yang menggunakan deep learning bekerja menggunakan data. Kita berikan data yang banyak untuk dipelajari, kita lakukan proses training/belajar, lalu kita akan mendapat model/agen yang cerdas.

Lalu muncul pertanyaan..

Proses pencarian data itu rumit, proses training itu makan waktu, kenapa kita tidak download saja model cerdas yang ada di internet lalu kita gunakan untuk masalah kita? tidak perlu train, dan tidak perlu ada data, beres kan?

Transfer Learning

Ide utama dari transfer learning ini kira-kira seperti ini,

Kita gunakan model yang sudah dicerdaskan orang lain untuk permasalahan kita, yang bahkan bisa jadi berbeda

Sebagai contoh, kita mau membuat sistem untuk menghitung kendaraan beserta jenisnya menggunakan kamera CCTV. Jika jenis kendaraannya yang ingin dideteksi cukup umum, semisal “mobil” atau “truk”, kita bisa jadi cukup browsing-browsing, dan kita akan menemukan orang yang sudah membuat model deep learningnya. Kita tinggal download, pakai, dan selesai! Kita telah memiliki model cerdas deep learning yang mampu mendeteksi mobil atau truk. Tanpa perlu mencari data, tanpa perlu melatih model.

Tapi seringnya permasalahan yang kita miliki sedikit berbeda. Sedikit saja perbedaan, maka kita sudah tidak bisa lagi pakai model orang lain ini. Contohnya, kita tidak hanya ingin mendeteksi “mobil” dan “truk” tapi juga “becak”. Permasalahannya, “becak” itu bukan kendaraan yang di mana-mana ada. Sangat mungkin model yang kita download tadi belum bisa mendeteksi becak.

Di sinilah, kita butuh transfer learning. Kembali ke ide utama di atas, dengan transfer learning, kita bisa memanfaatkan model orang lain yang sudah dilatih, untuk permasalahan kita yang berbeda.

Jadi ada 3 poin yang kita bahas di sini:

  • Model yang sudah dicerdaskan
  • Cara menggunakan model tersebut
  • Permasalahan yang (bisa jadi) berbeda

Oh ya, sebelum masuk lebih dalam, konsep Transfer Learning ini berlaku tidak hanya untuk arsitektur CNN saja. Tapi pada tutorial ini saya akan banyak mencontohkan menggunakan CNN karena lebih mudah dibayangkan.

Continue reading