
Tutorial kali ini kita akan membuat model Question Answer (QA), dengan menggunakan library transformer untuk NLP yakni Hugging Face. QA yang kita buat dapat menerima pertanyaan dalam format layaknya pertanyaan yang diajukan manusia, dan memberikan jawaban yang sesuai dengan konteks yang kita harapkan. QA adalah task yang menarik dan berbeda dengan retrieval, karena kita bukan searching keyword jawaban di database, meskipun perkembangan search engine bisa dikombinasi dengan task ini (bisa dibaca artikel menarik di sini https://blog.google/search-language-understanding-bert).
Ada 4 tahapan yang akan dieksplor di tutorial ini:
- Membuat Question Answer dengan DistillBERT
- Pre-trained Model Transformer Khusus
- Membuat Chatbot Telegram
- Integrasi Model Transformer QA ke Chatbot Telegram
1. Membuat Question Answer dengan DistillBERT
DistillBERT adalah varian BERT dengan kecepatan inferensi yang baik sehingga cocok digunakan untuk Question Answer system. Perbedaan DistillBERT, BERT, dan varian lain bisa juga dibaca di sini: https://towardsdatascience.com/bert-roberta-distilbert
Workflow
- Buat file Colab
- Install library transformers Hugging Face.
- Import class pipeline dari library transformer. Class ini memuat pre-trained model untuk berbagai task NLP dalam bahasa Inggris. Ada beberapa pilihan task NLP yang bisa kita gunakan misalnya sentiment analysis, translation, question-answering dll. Task yang akan kita gunakan adalah question-answering.
- Inisiasi pembuatan obect dengan class pipeline, isikan parameter pertama dengan
"question-answering". Step ini akan mendownload model untuk task question-answering sehingga hanya perlu di-run sekali. Inisiasi ini akan otomatis menggunakan model transformer DistillBERT, yang kecepatan inferensinya baik. - Object bisa digunakan dengan mengisikan pertanyaan pada parameter
questiondan konteks pertanyaan pada parametercontext.
Sebagai contoh akan diberikan pertanyaan “Where was Pink Floyd established?” dengan konteks “Pink Floyd was an English rock band formed in London in 1965.“. Implementasinya dituliskan pada code di bawah ini.
# Install library transformer dan Import class pipeline
!pip install transformers
from transformers import pipeline

# Inisiasi object dan Penggunaan pre-trained model QA
qa_model = pipeline('question-answering')
qa_model(question='Where is Pink Floyd established?',
         context='Pink Floyd was an English rock band formed in London in 1965.')
Hasilnya bisa dilihat di bawah, berupa dictionary dengan format key-value. Key answer bernilai string jawaban dari pertanyaan yang diajukan, score bernilai confidence level dari jawaban, sedangkan key end dan start menunjukkan posisi jawaban pada konteks yang diberikan. Bisa dilihat pula bahwa model dapat menjawab pertanyaan dengan jawaban benar sesuai konteks, meskipun detail seperti kata “formed” diubah menjadi “established”.
# Hasil
{'answer': 'London', 'end': 52, 'score': 0.9875053763389587, 'start': 46}
2. Pre-trained Model Transformer Khusus
Pada bagian ini akan ditunjukkan bagaimana menggunakan model pre-trained transformer lain yang dibagikan secara terbuka di website https://huggingface.co. Sebagai contoh adalah model BioBERT, yang secara khusus dibuat untuk keperluan ekstraksi informasi biomedis. Jika kita ingin membuat QA dengan konteks pada bidang biomedis maka model ini dapat digunakan.
Workflow
- Buka website library Hugging Face
- Cari model transformers yang akan kita gunakan yakni BioBERT (terkhusus untuk task QA biomedis) bernama ktrapeznikov/biobert_v1.1_pubmed_squad_v2. Penggunaan model ini hanya sebagai contoh, bisa juga digunakan model lain yang tersedia di website tersebut yang masih sesuai untuk task QA dan background biomedis.
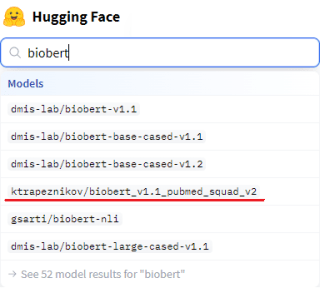
- Ubah parameter inisiasi objek dari class pipeline, masih mirip dengan workflow pada bagian sebelumnya. Tambahkan parameter
modelsetelah parameter pertama bernilai"question-answering", untuk mengganti default model QA dari DistillBERT ke model BioBERT yang kita inginkan. - Isikan konteks bacaan biomedis
- Isikan pertanyaan
Sebagai contoh akan diberikan konteks bacaan terkait malaria yakni “Malaria endemic countries in the southeast Asia region include Bangladesh, Indonesia and Thailand. Population movement and rapid urbanization, both largely caused by unemployment, and environmental deterioration change the malaria pattern.”. Kemudian diberikan pertanyaan “In what countriy is malaria endemic?” Code dan jawaban dapat dilihat di bawah ini.
# Tambah parameter model setelah question-answering
qa_pipeline = pipeline('question-answering',
                        model='ktrapeznikov/biobert_v1.1_pubmed_squad_v2')
qa_pipeline(question='In what countriy is malaria endemic?',
            context='Malaria endemic countries in the southeast Asia region include Bangladesh, Indonesia and Thailand. Population movement and rapid urbanization, both largely caused by unemployment, and environmental deterioration change the malaria pattern.')
{'answer': 'southeast Asia region',
 'end': 54,
 'score': 0.6932827830314636,
 'start': 33}
Hal menarik ketika dicobakan perubahan pertanyaan pada kata “country” menjadi “countries”, model dapat mengekstrak jawaban dengan lebih detail dari konteks bacaan yang sama.
qa_pipeline2(question='In what countries is malaria endemic?', context= '...'
{'answer': 'Bangladesh, Indonesia and Thailand',
 'end': 97,
 'score': 0.9252171516418457,
 'start': 63}
3. Membuat Chatbot Telegram
Pada bagian ini kita akan mengenal cara membuat chatbot Telegram sederhana, sebelum menerapkan model QA transformer yang telah kita buat. Chatbot yang dibuat nantinya bisa membalas “halo” ke semua chat yang masuk.
Workflow
- Akses Telegram, mulai chat dengan user BotFather, yakni bot yang gunanya untuk membuat bot lain 😆. Buat sebuah bot baru, copy token-nya. Gambaran cara membuat bot bisa dilihat di bawah ini. Saya membuat bot dengan nama QABot_with_DistillBert dengan username DisstillBertQA_bot. Meskipun di tahap ini bot kita belum menggunakan model QA, tapi bot ini nanti akan digunakan lagi pada tahap integrasi model QA transformer ke bot Telegram.
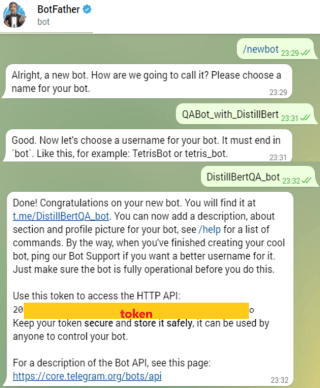
- Pada colab, Install dan import library pyTelegramBotAPI.
- Buat object dari class TeleBot. Setting parameter
tokenchatbot dengan token bot kita (didapat dari step 1). - Buat handler dan fungsi untuk merespon chat.
- Run chatbot.
- Buka Telegram, mulai chatting dengan bot yang barusan dibuat, maka bot akan membalas dengan “halo” untuk setiap chat kita.
Di bawah merupakan code untuk membuat bot. Ada yang disebut sebagai message handler, tempat kita mendefine fungsi untuk merespon chat. Untuk setiap chat yang lolos dari condition, maka fungsi di handler dijalankan. Sebelumnya saya juga mendefine handler untuk balasan command \start. Balasan didefine dengan fungsi send_welcome yang mereturn “Howdy, how are you doing? The bot will reply ‘halo’ to all of your chat.”. Bagian bawahnya merupakan handler untuk membalas semua chat dengan “halo”. Di handler tersebut fungsi lambda berfungsi untuk mencek isi chat. Karena kita akan membalas semua chat, maka di dalam fungsinya tidak ada condition “if” alias tanpa syarat, jadi otomatis return True. Kemudian chat akan direspon sesuai fungsi reply_all yang didefine di bawah handler.
# Install library dan import class
!pip install pyTelegramBotAPI
import telebot

# Inisiasi object dan setting token
token = 'isi token bot dari BotFather'
bot = telebot.TeleBot(token)

# Define fungsi untuk respon chat
# Respon utk /start
@bot.message_handler(commands=['start'])
def send_welcome(chat):
	bot.reply_to(chat, 'Howdy, how are you doing? The bot will reply -halo- to all of your chat.')

# Respon 'halo' ke semua chat
@bot.message_handler(func=lambda m: True)
def reply_all(chat):
	bot.reply_to(chat, 'halo')

# Run bot
bot.polling()
Terakhir, untuk menjalankan bot adalah dengan bot.pooling(). Maka chatbot Telegram sudah bisa kita coba seperti di bawah ini.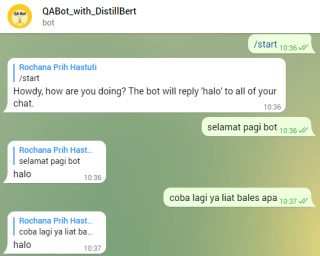
4. Integrasi Model Transformer QA ke Chatbot Telegram
Pada tahap ini kita akan meng-implemen model QA yang telah kita eksplor di tahap 1 ke bentuk chatbot telegram sesuai tahap 3. Kita akan gunakan model DistillBert untuk proses inferensi yang lebih cepat serta menggunakan konteks yang bersumber dari artikel Wikipedia.
Workflow
- Install dan import semua library di tahap 1 dan 3.
Tambahkan library Wikipedia untuk mengakses artikel di Wikipedia. - Setting token bot dan inisiasi object bot (seperti di tahap 3).
- Inisiasi object pipeline Hugging Face dengan parameter task
"question-answering". Karena akan menggunakan DistillBert, maka tidak perlu menspesifikasikan model (seperti di tahap 1). - Buat handler untuk menerima chat (seperti di tahap 3).
Kontrol status chat user dan bot dengan menerapkan conditional “if” sesuai kebutuhan. - Jalankan bot.
Code dapat dilihat di bawah. Status chat diatur dengan menginit suatu variabel sebagai state, yakni talk.
!pip install transformers
!pip install pyTelegramBotAPI
!pip install wikipedia
from transformers import pipeline
import telebot
import wikipedia

token = 'isi token bot dari BotFather'
bot = telebot.TeleBot(token)
qa_pipeline = pipeline("question-answering")

talk = 0 #var untuk status chat
su = ''  #var untuk summary konteks wikipedia
@bot.message_handler(func=lambda message: True)
def answer_the_question(message):

    global talk #var global, agar value bisa berubah ketika di dalam function
    global su

    if talk == 0:
      bot.reply_to(message, 'tell me a subject you wanted to talk about')
      talk = 1
      return

    if talk == 1:
      results = wikipedia.search(message.text)
      summary = wikipedia.summary(results[0])
      su = summary
      bot.reply_to(message, 'ask me a question about this topic')
      talk = 2
      return

    if talk == 2:
      a = qa_pipeline(context=su, question=message.text)
      bot.reply_to(message, list(a.values())[3])
      talk = 0
      return

bot.polling()
- Saat user pertama chat define state
talkke0.
Ketika user mengirim chat pertama, jawab dengan sapaan awal misal “tell me a subject you wanted to talk about.” - Kemudian state
talkberubah menjadi1.
User akan menjawab dengan sebuah topik (misal “Indonesia”). Jawaban ini kita inputkan pada methodsearchdari library wikipedia, untuk kemudian dicarikan artikelnya. Kemudian jalankan methodsummary, agar mendapat rangkuman dari topik tsb, sehingga bisa kita jadikan nilai parametercontextuntuk model QA.
Selanjutnya diberikan balasan untuk user, supaya chat berikutnya user merujuk ke bentuk pertanyaan misal “ask me a question about this topic.” - Kemudian state
talkberubah menjadi2.
User akan mengirimkan pertanyaan misal, “where is Indonesia?”. Ini yang kita gunakan sebagai paramquestionuntuk model QA kita. - Terakhir, balas dengan hasil jawaban dari model QA kita. Index
3merupakan indeks darikey answersetelah diconvert ke dalam bentuklist.
Gambaran setelah bot dijalankan sebagai berikut. Sebagai catatan bot Question Answer ini, kadang jawaban yang diperoleh bisa sedikit meleset atau kurang nyambung. Ini mungkin terjadi karena :
- konteks yang kita gunakan berupa summary, jadi kalau pertanyaan kita terlalu melebar bisa saja tidak termuat sama sekali di konteks yang dipakai
- model QA dengan DistillBert yang kita gunakan ini ditrain berbasis bahasa Inggris. ketika kita menginputkan topik yang tidak umum muncul dalam bahasa Inggris, maka kemungkinan besar akan kurang nyambung. misalnya saya cobakan topik durian seperti di gambar sebelah kanan, hasilnya kurang pas.
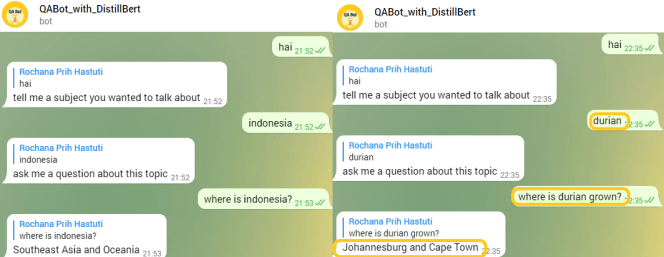
Jika ingin bot dengan jawaban yang lebih baik, maka kita bisa pilih model Question Answer dengan topik lebih khusus seperti yang telah kita coba di tahap 2. Selain itu jika menginginkan bot dalam bahasa Indonesia, maka kita juga perlu mencari model QA yang memang ditrain dengan bahasa Indonesia. Sekian artikel kali ini semoga bermanfaat 🤗
Notes:
Referensi utama artikel ini adalah liveproject Manning Publications Transformers to Create Chatbots.


mau tanya kak terkait PRE-TRAINED MODEL, kan ada pre-trained word embedding misal : Word2Vec ato FastText, nah yg ini pre-trained model transformer, BERT dll.
sebenarnya fungsi/manfaat dari 2 tipe pre-trained yg tadi sama ato berbeda ??
maksudnya misal Word2Vec itu berfungsi utk index kata yg sdh jadi vector ato seperti apa ? hehehe… mohon pencerahan kak
Wah maaf baru terbaca komentarnya.
Tujuannya beda-beda tergantung model pretrained apa yang dipakai. Pretrained model kan artinya model yang sudah dilatih (kita tinggal pakai), nah dilatih untuk apa bisa beda-beda tergantung siapa yang melatih. Untuk pretrained model yang menggunakan algoritma BERT saja ada banyak pilihannya, kalau di artikel ini, model BERT yang dipakai yang sudah dilatih untuk menemukan jawaban pertanyaan dari suatu teks. Kalau FastText atau Word2Vec mereka pretrained model yang bisa dipakai untuk word embedding (ubah kata jadi vector).