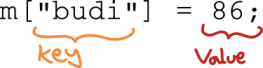Transfer Learning: Solusi Deep Learning dengan Data Sedikit

Salah satu permasalahan yang sering dialami ketika menggunakan deep learning adalah jumlah data yang sedikit. Di luar sana, sebenernya ada banyak solusi yang ditawarkan untuk mengatasi masalah ini. Nah, di sini kita akan bahas salah satunya, yakni Transfer Learning. Artikel ini akan berfokus pada teori di baliknya, sedangkan untuk implementasi akan ada di artikel selanjutnya.

Model Deep Learning

Sebelum masuk lebih dalam ke transfer learning, saya ingin mengingatkan sedikit tentang bagaimana konsep deep learning (secara umum machine learning) bekerja.
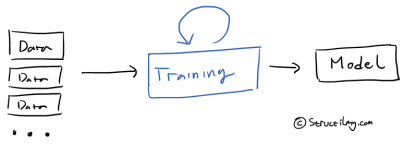
Suatu agen cerdas yang menggunakan deep learning bekerja menggunakan data. Kita berikan data yang banyak untuk dipelajari, kita lakukan proses training/belajar, lalu kita akan mendapat model/agen yang cerdas.

Lalu muncul pertanyaan..

Proses pencarian data itu rumit, proses training itu makan waktu, kenapa kita tidak download saja model cerdas yang ada di internet lalu kita gunakan untuk masalah kita? tidak perlu train, dan tidak perlu ada data, beres kan?

Transfer Learning

Ide utama dari transfer learning ini kira-kira seperti ini,

Kita gunakan model yang sudah dicerdaskan orang lain untuk permasalahan kita, yang bahkan bisa jadi berbeda

Sebagai contoh, kita mau membuat sistem untuk menghitung kendaraan beserta jenisnya menggunakan kamera CCTV. Jika jenis kendaraannya yang ingin dideteksi cukup umum, semisal “mobil” atau “truk”, kita bisa jadi cukup browsing-browsing, dan kita akan menemukan orang yang sudah membuat model deep learningnya. Kita tinggal download, pakai, dan selesai! Kita telah memiliki model cerdas deep learning yang mampu mendeteksi mobil atau truk. Tanpa perlu mencari data, tanpa perlu melatih model.

Tapi seringnya permasalahan yang kita miliki sedikit berbeda. Sedikit saja perbedaan, maka kita sudah tidak bisa lagi pakai model orang lain ini. Contohnya, kita tidak hanya ingin mendeteksi “mobil” dan “truk” tapi juga “becak”. Permasalahannya, “becak” itu bukan kendaraan yang di mana-mana ada. Sangat mungkin model yang kita download tadi belum bisa mendeteksi becak.

Di sinilah, kita butuh transfer learning. Kembali ke ide utama di atas, dengan transfer learning, kita bisa memanfaatkan model orang lain yang sudah dilatih, untuk permasalahan kita yang berbeda.

Jadi ada 3 poin yang kita bahas di sini:

  • Model yang sudah dicerdaskan
  • Cara menggunakan model tersebut
  • Permasalahan yang (bisa jadi) berbeda

Oh ya, sebelum masuk lebih dalam, konsep Transfer Learning ini berlaku tidak hanya untuk arsitektur CNN saja. Tapi pada tutorial ini saya akan banyak mencontohkan menggunakan CNN karena lebih mudah dibayangkan.

Continue reading

Object Detection dengan PyTorch Detectron 2 dan Colab

Pada tutorial ini kita akan coba membuat object detection model dengan custom dataset kita sendiri menggunakan PyTorch Detectron 2.

Facebook Detectron 2 adalah salah satu python framework yang dapat digunakan untuk kasus object detection. Detectron dikembangkan oleh Facebook dengan menggunakan basis PyTorch sebagai deep learning frameworknya. Bagi yang belum tahu tentang PyTorch, bisa cek website resminya atau kunjungi tutorial kami sebelumnya di sini.

Framework lain untuk deteksi objek yang cukup populer adalah Tensorflow object-detection API (TFOD) yang dikembangkan oleh Google. Keduanya hampir memiliki fitur utama yang sama, salah satunya mereka menyediakan Model Zoo, di mana kita bisa mulai proses training menggunakan model yang sudah ada (pretrained model).

Artikel telah di update 16 Januari 2020 pada perubahan instalasi Detectron 2 versi 0.3

Detectron 2 Tutorial

Pada tutorial ini kita akan menggunakan Google Colab. Contoh code yang akan dibahas pada artikel ini tersedia di sini.

Detectron 2 Logo
  1. Dataset
  2. Instalasi
  3. Menyiapkan DatasetCatalog
  4. Training Model
  5. Save and Load Model

1. Dataset

Dataset yang akan kita gunakan sama dengan dataset dari tutorial sebelumnya. Kita akan mendeteksi pada suatu citra apakah ada kangguru atau rakun. Penjelasan detail format data dan bagaimana memprosesnya dapat dilihat pada artikel sebelumnya. Tapi, karena artikel sebelumnya digunakan untuk object detection dengan Tensorflow sedangkan kita di sini akan menggunakan PyTorch Detectron, maka kita tidak perlu memproses data sampai membuat file tfrecord, cukup sampai bagian membuat file csv.

Dataset latihan dapat didownload melalui github dengan menuliskan perintah berikut di google colab. Detail dataset dapat dibaca di file Readme:

! git clone https://github.com/rianrajagede/object-detection.git
Continue reading

Melanjutkan Training Extend FastText Model

Artikel kali ini membahas bagaimana cara melanjutkan training atau extend Fasttext model yang sudah ada, dengan menambahkan dataset baru. Pada artikel sebelumnya, Word embedding dengan Fasttext bagian 1.5, telah dibahas cara menggunakan model pre-trained Fasttext word embedding dalam Bahasa Indonesia yang disediakan oleh Facebook. Manfaat dari extend model adalah kita bisa menambahkan kosa kata baru ke dalam vocabulary model pre-trained Fasttext, tanpa perlu train ulang dari awal.

Definisi model pre-trained di sini tidak terbatas pada model pre-trained yang disediakan Facebook, tapi bisa juga berupa model word embedding Fasttext yang sudah kita train sendiri sebelumnya. Namun untuk contoh, akan digunakan model pre-trained Fasttext Bahasa Indonesia dari Facebook.

  1. Load Pre-Trained Model FastText dari Facebook
  2. Cek Model Awal
  3. Menyiapkan Dataset
  4. Extend Model
  5. Cek Model Setelah di-Extend
Continue reading

Step-by-step Backpropagation Menggunakan Python

Pada artikel sebelumnya, kita telah melihat step-by-step perhitungan backpropagation. Pada artikel ini kita kan mengimplementasikan backpropagation menggunakan Python

Kita akan mengimplementasikan backpropagation berdasarkan contoh perhitungan pada artikel sebelumnya. Karenanya perlu diingat kembali arsitektur dan variabel-variabel yang kita miliki. Berikut arsitektur jaringan saraf tiruannya:

Variabel $x$ menunjukkan input dari jaringan saraf tiruan kita. Pada contoh ini kita hanya akan menerima sebuah input yang memiliki 3 fitur, yang bernilai $x_1=1.0$, $x_2=2.0$, dan $x_3=0.5 $ atau dapat kita tulis sebagai berikut:

$$ X = [1.0, 2.0, 0.5] $$

Untuk bobot jaringan, jika diperhatikan terdapat 6 bobot $w$ yang menghubungkan neuron input dengan neuron output. Untuk memudahkan penamaan, kita simbolkan $w_{ij}$ berarti bobot yang menghubungkan neuron input nomor $i$ ke neuron output nomor $j$. Penamaan ini kita ikuti dari artikel sebelumnya. Jika dituliskan dalam bentuk matriks dengan $i$ menjadi nomor baris dan $j$ menjadi nomor kolom maka tampak seperti berikut:

$$ \begin{bmatrix}
w_{11} = 0.2 & w_{12} = 0.3 \\
w_{21} = 0.3 & w_{22} = 0.1 \\
w_{31} = 0.3 & w_{32} = 0.2
\end{bmatrix} $$

atau bisa dituliskan:

$$ W = \begin{bmatrix}
0.2 & 0.3 \
0.3 & 0.1 \
0.3 & 0.2
\end{bmatrix} $$

Nilai bias b pada latihan ini kita beri nilai 0 untuk $b_1$ dan $b_2$:

$$ B = [0, 0]$$

Jangan lupa juga kita buatkan variabel $T$ yang merupakan label/target asli dari data (groundtruth) dengan nilai $t_1=0$ dan $t_2=1$ (sesuai dengan artikel sebelumnya). Nantinya hasil prediksi $Y$ dari model akan dibandingkan dengan variabel ini.

Pada proses di atas kita melakukan yang namanya vektorisasi atau mengubah representasi nilai menjadi vektor atau matriks. Nantinya ini akan memudahkan perhitungan kedepannya. Di Python proses deklarasi variabel-variabel tersebut dapat dituliskan sebagai berikut:

X = [1, 2, 0.5]
W = [[0.2, 0.3],
    [0.3, 0.1],
    [0.3, 0.2]]
b = [0, 0]
T = [0, 1]
Continue reading

Tutorial Struktur Data Map Pada C++

Artikel ini adalah rangkaian tutorial struktur data pada C++ untuk persiapan Kompetisi Sains Nasional bidang Komputer 2020. Pada artikel ini kita akan bahas Struktur Data Map. Cek juga artikel sebelumnya tentang struktur data Vector.

TL;DR; Bagi yang agak pingin cepat, bisa baca tutorial di codingannya langsung di link berikut ini https://ideone.com/1Y7b2b

Apa itu struktur data map?

Untuk memudahkan membayangkan, kita bisa lihat langsung contoh bagaimana pemakaian Struktur data Map ini. Map terasa mirip dengan array namun dengan index yang memungkinkan untuk berupa tipe data selain integer (mirip dengan dictionary di Python). Pada map, indeks tersebut diberi nama “key”.

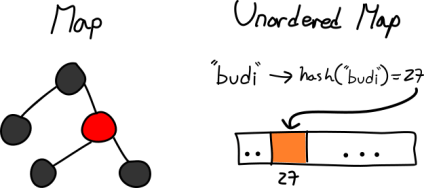
Di C++ ada 2 jenis struktur data map, yakni std::map dan std::unordered_map. Kedua struktur data tersebut secarafungsi bisa dibilang hampir sama, yang membedakan adalah implementasi dibaliknya. Pada std::map digunakan Self-Balancing Tree khususnya Red-Black Tree, sedangkan pada std::unordered_map digunakan hash table.

Perbedaan tersebut memunculkan dua karakteristik unik (sesuai namanya). Pada std::map, data disimpan secara terurut menaik berdasar key nya, sedangkan unordered map tidak terurut. Detailnya bisa dicek di bagian “Iterasi” di bawah.

Continue reading